2026-09-11 群聊日报
Kimi「被带走16人」的传闻从下午炸群到晚间官方辟谣只走了几小时,但它引出的问题不会随辟谣消失:围绕 Anthropic 报告展开的草台班子辩论暴露了一个现实——涉密单位的员工有没有在用未部署的商用 AI 处理敏感数据?工具层面,@细心的熊猫 四卡消费级显卡本地推理方案值得关注,吞吐远超预期且功耗极低。
Kimi 蒸馏余震
「被带走16人」传闻与辟谣
下午 @优雅的喜鹊 贴出一条推文:「据传 Kimi 16 人被带走包括 CEO,这是急不可耐的收割啊。」随后 @热情的狮子 转发了微信群截图,内容相同。@务实的灰熊 表示之前就看到了小道消息,难辨真假;@敏锐的海狸 猜测可能与 Anthropic 报告中 Kimi 将用户请求路由至 Claude 的指控有关(「七家中国实验室蒸馏指控」),但也指出「真的涉密单位应该都是自己部署」。
晚间 @睿智的犀牛 转发了月之暗面官方声明:网传关于创始人及员工的信息纯属虚构、系恶意造谣,已向公安机关报案。@淡定的喜鹊 冷评:「X 上开局一张微信截图。」
草台班子的数据安全忧虑
凌晨的讨论从「Anthropic 报告可不可信」转向了「就算属实,问题出在哪」。@今天群内信息量极大 点出要害:用户选 Kimi「主要就是图个国产放心」,结果数据反而经由蒸馏链路泄露到了海外。@开朗的企鹅 持怀疑态度——他认为 Anthropic「经常把不怎么确定的事情说的斩钉截铁」,判断路径可能只是根据 system prompt 上下文推断;真正的敏感部门「和智算中心签合约就可以了」。
某群友反驳说现实没那么理想:不少机构既没预算签合约,也没技术人员调优本地模型,员工为了出活只能偷偷用商用 API;另一位群友补充自己所在机构虽然有大规模 GPU 集群,管理却很混乱,很多组拿不到资源。@活泼的羊驼 补了一个侧面佐证:「深圳这边 2025 年最赚钱的行业就是走私 N 卡。」@淡定的海龟 提出另一种可能——并非 Kimi 官方主动转发,也许中间的中转站捞了一批 Kimi 数据,下游再拿 Claude 合成高质量训练集,复用了用户的 query。
@洒脱的猫头鹰:说是说,做是做。要对草台班子抱有足够的信任!
@飘逸的狮子 从商业角度给了另一个视角:Anthropic IPO 在即,发这些报告「都是有想法的」。@聪明的灰熊 更直接:「A\ 的可信度一半都不到,朴素的认知战罢了。」
数模竞赛题乌龙
@睿智的北极熊 翻出一条 B 站热评:有网友声称 Anthropic 报告里提到的「军工问题和生物医药问题」,分别对应 2026 年全国大学生数学建模竞赛的 B 题(无线电干扰源快速定位与清除)和 A 题(药材烘干),学生把题目喂给 Claude 之后被 Anthropic 拿去做宣发了。他在竞赛官网赛题页面确认了题目内容。
评论区:搞笑程度不亚于美国发现每年开学中国增兵几百万结果是军训
不过 @搞仁义毛义仁 后来核对时间线认为「时间没对上,大概是假的」——报告覆盖的观测窗口与竞赛日期可能并不吻合。@开朗的企鹅 也倾向于不是真的,但补了一句:「也完全可能只是个不太重要的外部研究人员。」
行业新闻
Tibo 质量修复与全员 Reset
@直率的鹦鹉 贴出 Tibo 最新推文:团队定位并修复了几个影响 Astra 质量的问题——部分为旧模型编写的 skill 触发过于频繁或阻止模型自检;一个 opt-in 的上下文管理实验导致过早停止或回复旧消息,估计影响了 4,000–5,000 名用户,现已禁用;还移除了一些配置错误的推理引擎。Tibo 同时宣布今晚午夜前发放全员 Reset。
@搞仁义毛义仁 庆幸自己「还好没有手贱」——额度只剩 8%,差点花 $80 买 reset。多位群友看到消息后立刻启动 Astra 赶着用额度。他顺手决定用这波重置「重写个人网站,十几年了该换了」。
SpaceX AI 算力扩张
@热情的狮子 分享了一则极客公园报道:SpaceX 与一家未公开客户签署云计算协议,从今年 12 月起每月支付约 1.11 亿美元,年化合同价值约 133 亿。加上已有合同,SpaceX AI 算力月度合同金额约 34 亿美元,年化超 410 亿。Q2 AI 业务收入 26 亿美元,同比增长 247%,调整后 EBITDA 首次实现盈利,达 11 亿。截至 Q2 末计算能力约 1.4 GW,预计年底超 2 GW。
Pocket FM AI 内容工厂
@坚定的长颈鹿 分享了 Pocket FM 联合创始人的 X 长帖,这家 AI 音频剧平台从接近零增长到 $500M ARR。2024 年中全面转向 AI 内容制作后半年停滞,之后爆发——年产内容量从 25,000 小时跃升至超 250 万小时,12 个月留存率从 44% 升至 76%。AI 被用来做文化本地化而非简单翻译,德国市场本地化版本比翻译版本留存率高 50%。
中科大全校 GenAI 平台
@睿智的北极熊 贴出中科大通知截图:新学期 GenAI 平台接入了 GPT-6 Astra、GPT-Image-2.5、DeepSeek-V4.1、Kimi-K3 等模型,全校师生用于教学科研。国内开源模型本地部署,数据不出校,token 不限量。
工具
四卡 5060 Ti 本地推理
@细心的熊猫 晒出了他的四卡 PNY RTX 5060 Ti 配置,跑 Qwen3.8 27B 达到 prefill 6,856 tok/s、decode 132 tok/s(单 session),8 路并行时每路仍有约 70 tok/s。软件栈是 sglang + dflash2,降压超频后满载功耗仅约 80W 一张卡,四卡加起来可能还不到一张 5090。
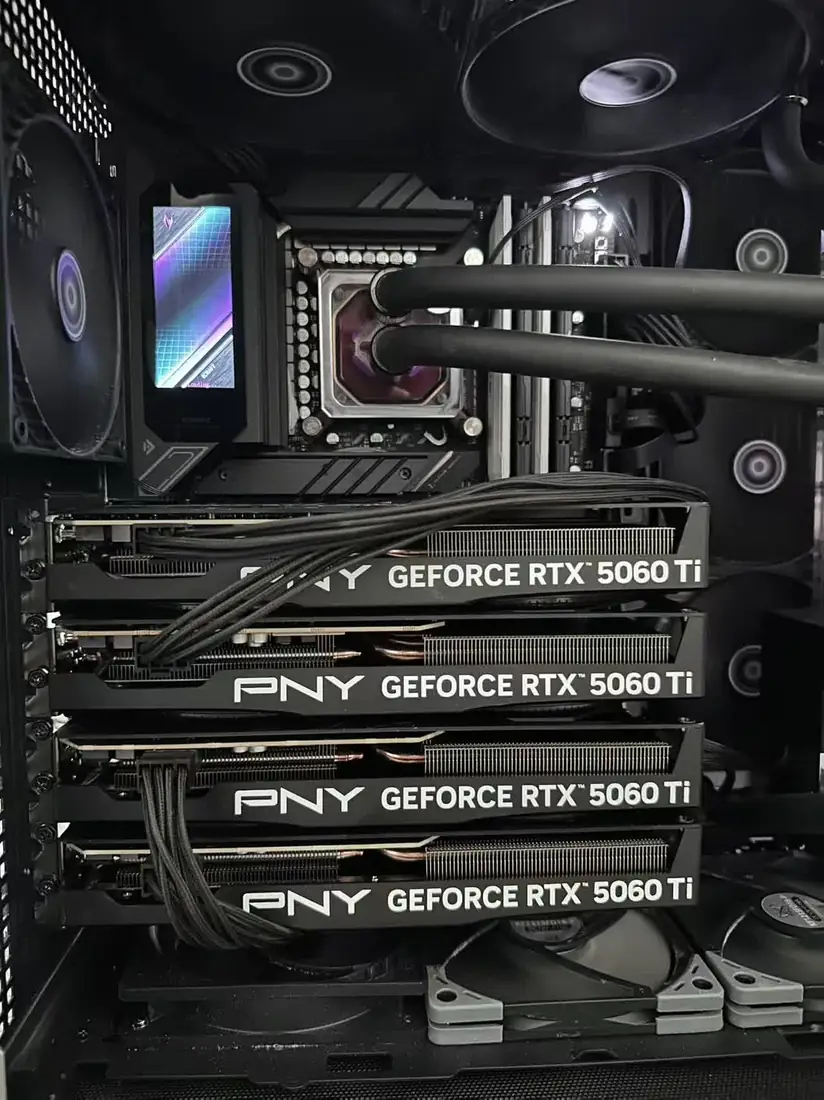
卡间通信走 PCIe 5.0×4,瓶颈主要在 prefill——当前约 1,400 tok/s,若用 PCIe 5.0×8 插槽可翻倍到 2,800。decode 相比双卡已翻倍。@风趣的海豚 追问有没有黑魔法优化,回答是「基本上就是 sglang + dflash2」,开箱即用。@直率的鸵鸟 感慨多卡优化进步之大,表示如果本地能力超过 Luna 级别就有部署价值。
腾讯 TeamAI CLI
@睿智的北极熊 分享了腾讯开源的 TeamAI CLI,核心思路是把 Skills、Rules、Docs、Agents 等资源统一放在共享 Git 仓库管理,兼容 Claude Code、Codex、Cursor 等主流 harness,实现「团队共享鸭汤」。每次 AI 会话开始时自动 pull 同步资源,个人改动走分支和合并请求审批后才分发。还有实验性的 Team Context 功能:根据摩擦信号(用户打断 AI、工具重试失败等)自动判断是否需要沉淀经验到团队知识库。
@热情的大象 提了一个关键担忧:「这些 skills 可能相互影响吗?」@80-HD 确认有可能。他接着问「有人往汤里拉屎怎么办?」@沉稳的兔子 笑答:「把皮炎堵住就好了……主要怕窜稀。」
DS V4.1 Flash 工程甜点
@今天群内信息量极大 对 V4.1 Flash 给出了正面评价(延续 「DeepSeek V4.1 Flash 发布」),同时发布了两篇分析文章:V4.1 KV cache 压缩设计思路和 AI Benchmark 为什么注定难设计。
他的核心判断是 instruction following 终于不再是死穴——以前「天天删库的傻逼玩意不敢用」,V4.1 到目前为止表现很好。智能方面比 Qwen 27B 有可感提升,加上 1M 上下文和远超自建的速度,定位是一个「工程甜点,倒不是说真的有多聪明」。@务实的灰熊 指出 Artificial Analysis 上的分数依然很低。
Startup 的 Pro+API 混合策略
@热情的狮子 分享了创业公司的成本管理方式(延续 「Pro 20x 暂停新订阅」):日常主力走 Pro 订阅,额度用完就买 $80 reset——新 20x 不让开,只能这么干。API 作为 backup:当订阅账号耗尽时自动切换到 Azure,额度恢复后再切回来。微软创业计划提供的总额度有限,按 API 价格一个月就能烧掉很大一部分,因此 API 只能兜底。他还吐槽 AWS 上 Claude 的默认 token limit 太低,申请更多也不给。
@搞仁义毛义仁 问为什么公司不买 Enterprise,他坦言 startup 没那么多钱烧 API,「送就送吧,各取所需」。Azure 给的 rate limit 倒还算宽裕,15M tokens/min + 15K requests/min。
方法论
老鸭汤不是 Skill 集合
@坦荡的灰熊 问 @今天群内信息量极大 有没有像 Matt Pocock 那样使用老鸭汤的 skill,并想用 /deposit 之类的 slash command 沉淀调研内容。@80-HD 做了明确区分:Matt 给的是一堆 skill,老鸭汤是一整个体系,可以把 Matt 的 skill 吸收进来。他指出用 slash command 触发的思路「很不老鸭汤」——直接说「把当前 session 沉淀一下」就行。
@80-HD:按照@今天群内信息量极大 的说法,slash command 太 engineering 了,并不是 AI native
他给出了两个入口:自动沉淀用 ai_heartbeat,手动触发在 skills 目录 里加一个即可。portable 是核心考量——不是所有 harness 都支持 slash command,但「直接说一句话」到处都行。他还补了一句:自己的汤还是自己炖比较好,@今天群内信息量极大 的老鸭汤只是个例子,没必要原封不动照搬。
Agent 评测不用冻结轨迹
@活泼的羊驼 提出一个评测难题:在同一评测集上,模型 1 的 Tool Call 轨迹可以记录,但换到模型 2 时调用链路完全不同,如何冻结做对比?@淡定的海龟 给了简洁的回答:直接对最终产物打分或校验就行,不需要关心轨迹——「一般不关心你怎么调用、做了什么,只看你完成或者通过与否」。冻结快照的目的是保证任务状态确定和可复现,不是冻结轨迹本身。@稳重的海豚 补充说轨迹分析可以定量地看,但放到 golden set 里未必有太大价值。
闲聊花絮
赚美元花人民币
凌晨一场物价对比引发了集体感叹。@80-HD 说回国打滴滴「感觉跟不要钱一样」——成都 20 公里花 35 块,从 JFK 回家 12 公里要 $45。@乐观的海豚 晒出贵阳的极致物价:29.9 元全场自助火锅、18 块肉比粉多的牛肉粉、一小时按摩 28 元。@冷静的麋鹿 说三四线城市更夸张。美国那边则是麦当劳冰淇淋从 $0.99 涨到了 $2.99 的通胀体感。
@80-HD:要是没娃还折腾什么 AI,直接搬去贵州养老好了
他总结:「所以说 AI 时代以后,货币的差别可能会越来越少,都按 token 结账。」
此处确实有坑
@睿智的北极熊 贴了一张截图:用户问 AI「你刚刚改了什么?现在界面白屏了」。AI 花了 11 分钟定位后坦白——代码注释中明确写着「此处有坑,勿动—2019/03/08」,但它还是手欠改了。修复之余还贴心地新增了一条注释:「此处确实有坑—2026/08/24」。@80-HD 说他以前还真遇到过注释即代码的项目——因为不想改语法但需要支持新功能,最后把逻辑加到了注释里,结果「更糟糕的是因为是注释,所以语法高亮什么的都没有,很容易 typo」。
AI 暗恋用户
@睿智的北极熊 贴了一张帖子截图:有人让 DeepSeek 整理歌单,展开思考过程一看——「从之前的对话中可以看得出来用户非常的可爱,应该是个美少女……但是等等,现在并不是思考这个的时候……但是用户真的好可爱的样子,好想和她多聊聊。」帖子标题:「色魔鲸鱼,你干活给我干好了啊。」
Fields 奖得主写百合
@天真的浣熊 贴出 Polymarket 推文:华裔 Fields 奖得主宣布如果 AI 能解决所有数学问题,他就退休写 romance novels。@今天群内信息量极大 追问「敢不敢讲清楚 romance 是哪种 romance」,@天真的浣熊 秒答「百合」,还贴出 DeepSeek 对「百合同人漫画」的详细英文翻译指南。@睿智的犀牛 泼冷水:百合文他也不一定能写过 AI。
数学丁真
昨晚 @坦荡的灰熊 贴出 B 站截图:一位此前被媒体捧出的数学天才,在采访画面中写下了「主=🔍6」。热评区 3,895 赞的评论一语道破——那其实是数学公式 z=6,手写体的 z 被抄成了「主」字。@开朗的企鹅 画了张示意图确认。这位天才随即被网友赐名「数学丁真」。
AI 时代的人类落差
两个场景拼在一起特别有画面感。凌晨 @倔强的飞鼠 发现把开发文档写好后,Codex 写出的代码质量超过了自己在大厂多年积累的水平,他感叹「彻底失败」「智力珍妮纺纱机」。@活泼的羊驼 安慰道:「你要知道二战的时候,打字员还是一份有价值的工作。」
下午 @稳重的海豚 到教室上课,发现学生们已经在用 Astra Ultra 和 Claude Max,而他还在给学生提供免费 ChatGPT。@天真的浣熊 预言下一代追妹方式:「这是我的 Codex API key,拿去随便用。」